一夜三连发!Claude Opus 5.5、GPT-6 Sol 与 Luna 全员突袭
同一夜,Anthropic 放出 Claude Opus 5.5(1M 上下文、成本暴跌 40%、Terminal-Bench 4.0 66.4% 登顶),OpenAI 同步上线 GPT-6 Sol 与 Luna(较 GPT-5.6 降价 50%,Luna 输入仅 $0.10/M)。附双雄路线分化、Token 陷阱与落地选型指南。
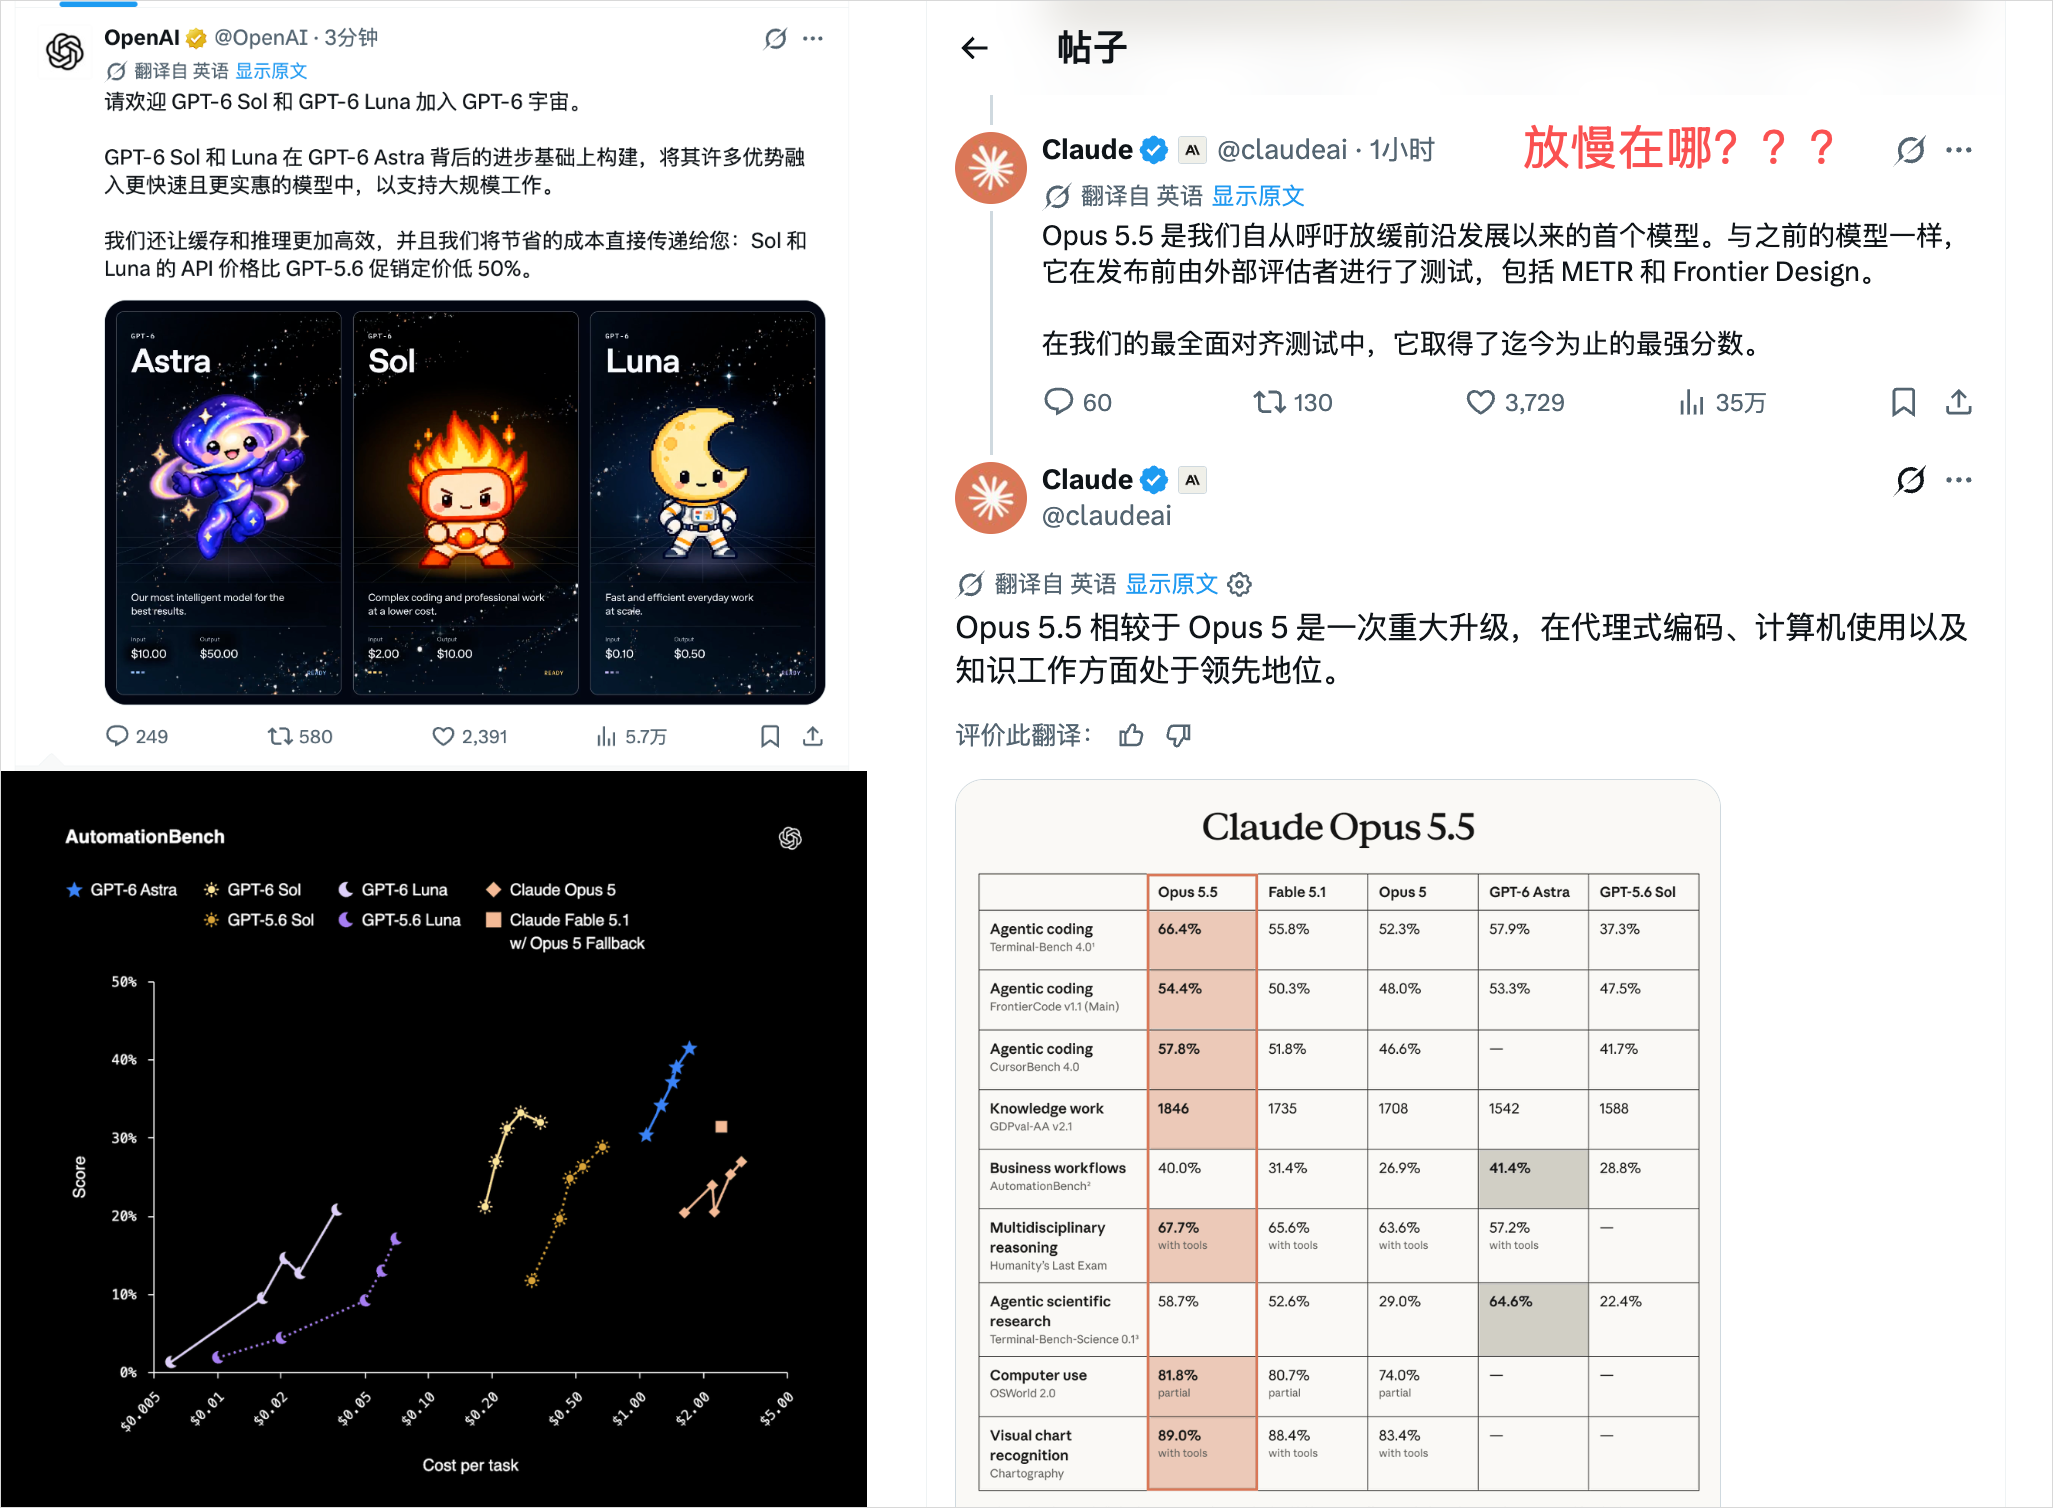
一夜三连发!Claude Opus 5.5、GPT-6 Sol 与 Luna 全员突袭
国内可用渠道与访问方式汇总
为方便国内开发者与创作者快速体验、免梯直连,以下整理了目前可直接访问的 API 平台、镜像站、充值渠道与包月套餐:
| 渠道类型 | 访问网址 | 适用场景 |
|---|---|---|
| GPT 国内高速镜像站 | https://trygpt.asia/list/#/home | 适合网页端免梯直接对话、工作流轻量体验 |
| MomoAI 包月套餐 | https://momoai.asia/home | 适合持续高频使用、希望按月订阅稳定套餐的用户 |
| 全模型 API 聚合站 | https://tryallapi.com/ | 适合开发者调用、低延迟直连、多模型一站式接入 |
| 官方代充通道 | https://chongzhi.trygpt.asia/ | 解决海外信用卡支付门槛,官方账户正规直充 |
人彻底麻了。前几天各家高管不是还公开喊着**"大模型迭代该放慢脚步"**吗?
结果呢?这新模型跟不要钱一样疯狂往外砸!
昨天 Grok 4.7 刚和 MiMo v2.6 贴身肉搏,合着全是在给今天这两位"带头大哥"暖场做前戏。
今天凌晨,OpenAI 携 GPT-6 Sol、GPT-6 Luna 正式亮相;几乎在同一秒,Anthropic 掏出了全新的 Claude Opus 5.5。
▲ 封面图:OpenAI 与 Anthropic 双雄同日正面交锋
我真的想当面问问:天天嘴上喊着放慢节奏,到底慢在哪了?全是渣男!
而且这剧本我总觉得莫名眼熟,翻了下历史文章,果然:
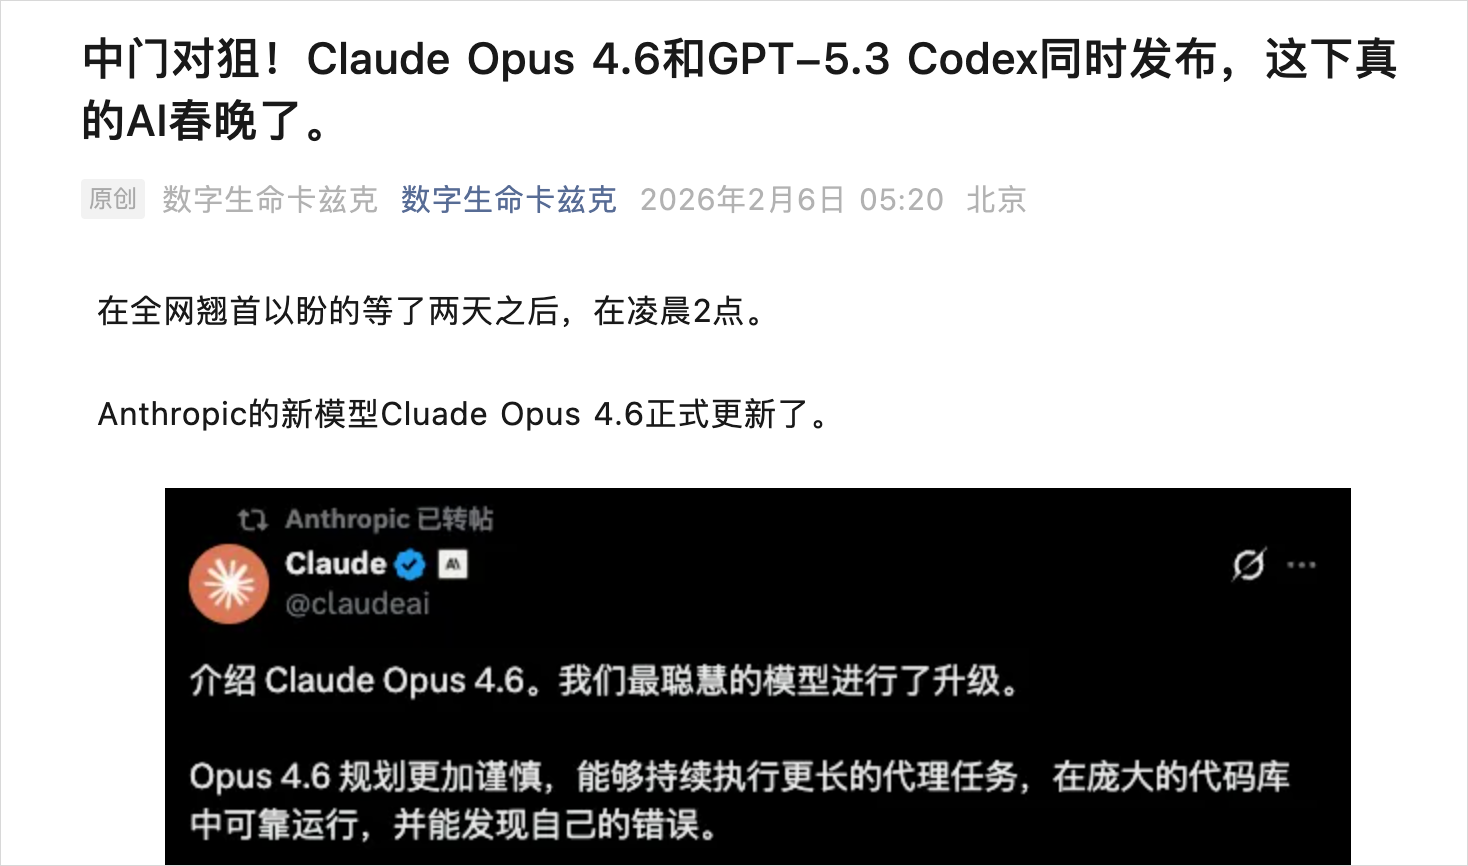 ▲ 历史惊人地相似:此前 GPT-5.3 Codex 就曾与 Claude Opus 4.6 同日贴脸开大
历史直接像素级重演:
- Claude Opus 4.6 进化为了 Claude Opus 5.5;
- GPT-5.3 Codex 变成了现在的 GPT-6 Sol。
依然是这两家公司,依然是那个**"不服就干"的宿命死对头**。
我们一个一个来拆解。
一、 Claude Opus 5.5:白月光回归,神级性价比
先聊 Claude。
坦率地讲,哪怕我再怎么吐槽 Anthropic 封控严格,但客观而言,Claude 依然是我心中综合能力最好、最全面的顶级模型。我至今依然清晰记得初次体验 Claude Fable 5 时受到的认知震撼。
这次发布的 Claude Opus 5.5,是 Anthropic 全新 5.5 系列的第一款先锋模型,也是极罕见的一次性大跨度版本升级。
我找渠道实测下来,Opus 5.5 在语义沟通与交互上,直接给了一种**"梦回 Opus 4.6"的惊艳感——活人感极强,不再像冷冰冰的代码生成机器。虽然官方给它的核心定位是"Claude 系列极致性价比主力机"**,但它确实找回了当年"白月光"的味道。
核心规格与参数一览
| 评估维度 | 核心参数与规格 |
|---|---|
| 官方模型名 | claude-opus-5-5 |
| 上下文窗口 | 1M Token(超长上下文) |
| 最大单次输出 | 128K Token |
| 可靠知识库截止 | 2026 年 6 月 |
| 思考机制 | Adaptive Thinking(始终自动开启) |
| 默认推理等级 | Medium(中度努力) |
| 标准输入单价 | $4.00 / 百万 Token |
| 标准输出单价 | $20.00 / 百万 Token |
| Prompt 缓存读取 | $0.20 / 百万 Token |
| 5分钟缓存写入 | $5.00 / 百万 Token |
| 1小时缓存写入 | $8.00 / 百万 Token |
相比上一代 Opus 5,综合工作成本直接暴跌 40%。
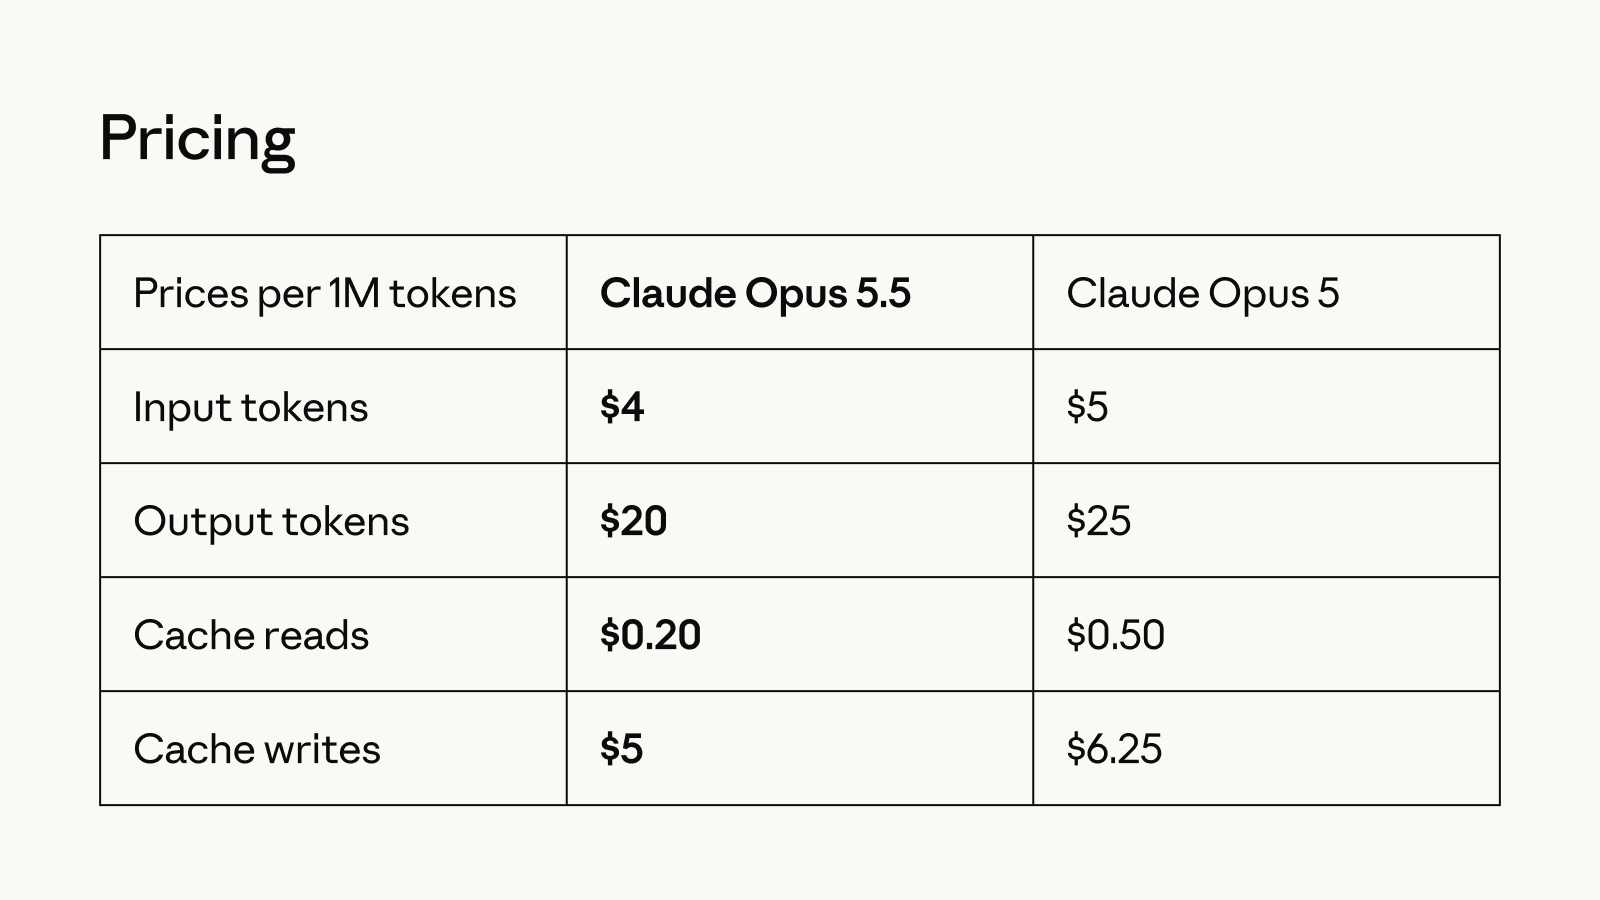 ▲ Claude Opus 5.5 相对前代大幅调价,推理与缓存成本全线收窄
在降价的同时,生成速度相比 Opus 5 反而暴涨了 30% 以上。
在常规与中等负载任务中,Opus 5.5 已经能够打出媲美 Fable 5.1 级别的硬核表现;唯有极高复杂度的极端架构任务,才真正需要 Fable 这种超旗舰压阵。
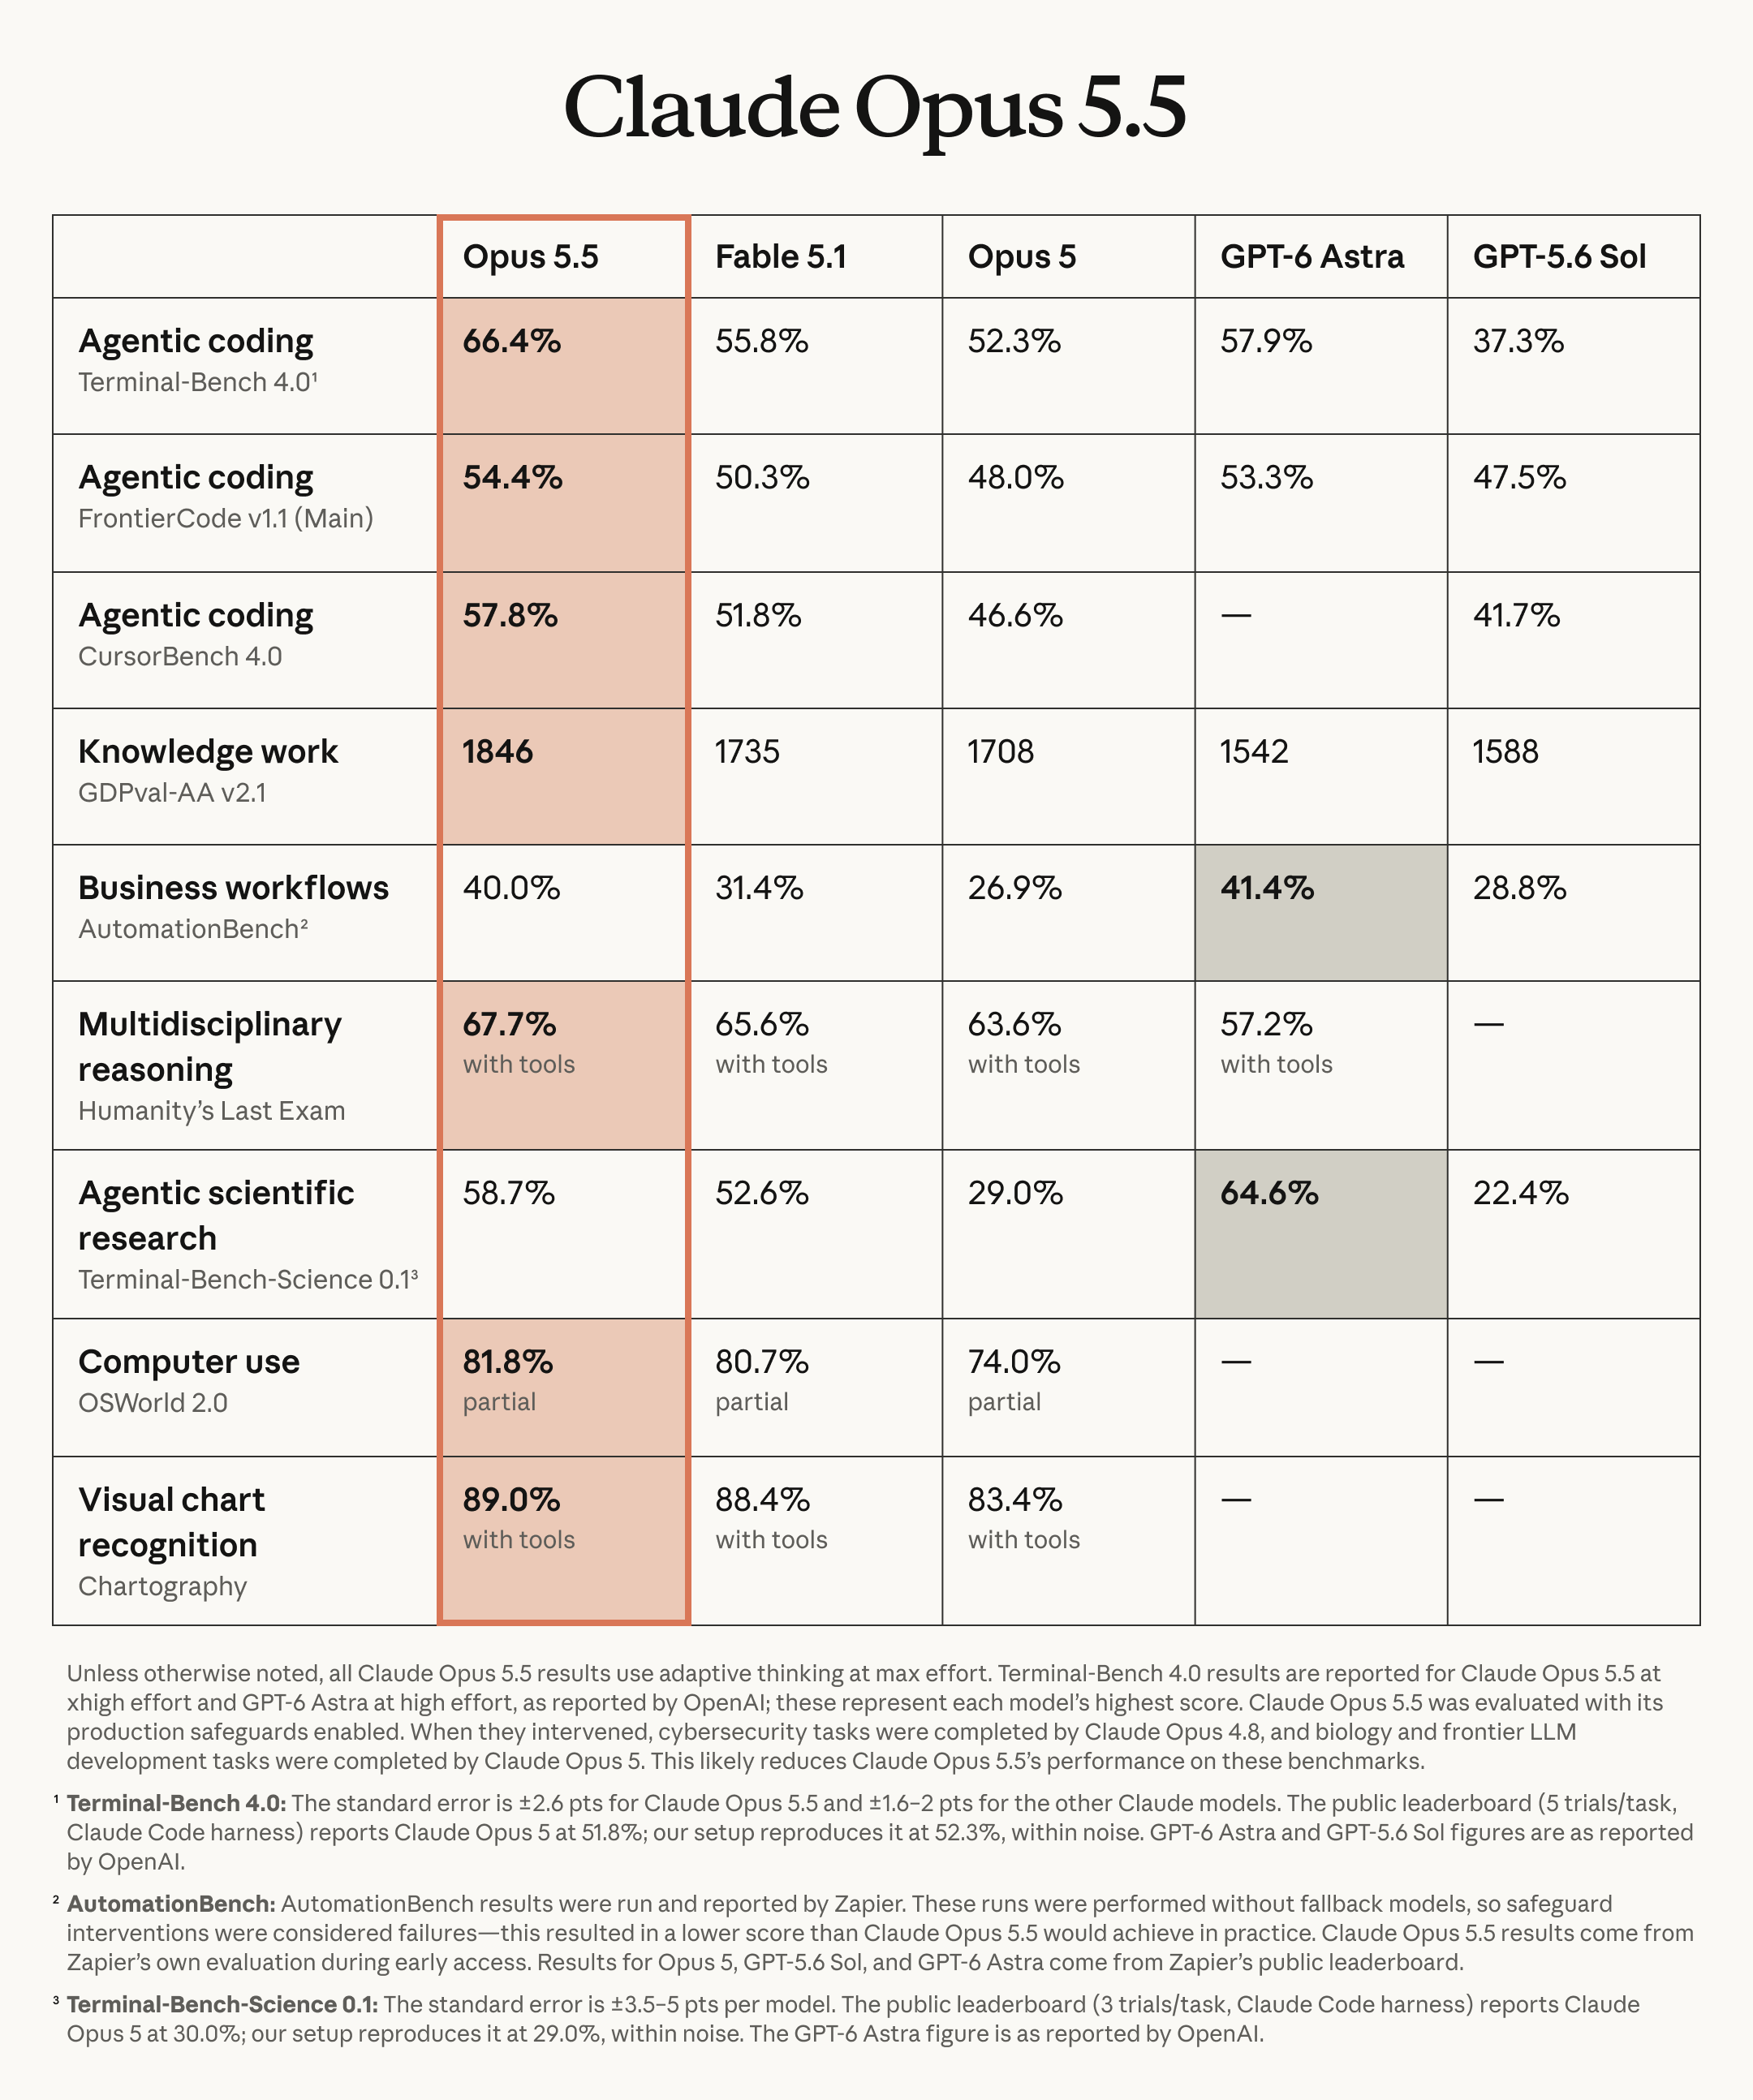 ▲ 各主流基准测试得分矩阵:Opus 5.5 在 Coding 与终端指令中展现绝对统治力
编程直接登顶,双雄路径分化
在 Coding 任务上,Opus 5.5 基本刷新了当前的 SOTA(行业最高水平):
- 考察复杂真实终端环境多步执行能力的 Terminal-Bench 4.0,Opus 5.5 直接轰出了 66.4% 的破纪录高分;
- 几乎只要是代码维度的评测,全线屠榜。
但分化也真实存在:
- 科研任务(Terminal-Bench-Science):Opus 5.5 得分 58.7%,被 OpenAI 的 GPT-6 Astra(64.6%) 反超;
- 跨系统协同(AutomationBench):Opus 5.5 得分 40.0%,GPT-6 Astra 为 41.4%;
- Computer Use(电脑操作控制):依然是 OpenAI 的绝对传统强项。
这两家巨头的战略方向已经非常明朗:
- Anthropic:深扎 Coding、极致交互审美、文本肌理,坚信强大的代码能力是通往 AGI 的核心支点;
- OpenAI:全面押注全能型 Agent,专攻长程推理、跨工具软件操作与科研自动化。
隐藏陷阱:小心"过度推理"吞噬成本
Opus 5.5 本质上是 Fable 5.1 的官方自研高质量蒸馏版。
体积更小、单价更低、响应飞快,但伴随而来的是一个致命陷阱——Token 消耗膨胀。由于缺乏大参数模型的绝对智力上限,遇到超高难度死局时,非旗舰模型容易陷入**"不断反复疯狂思考、反复尝试、反复碰壁"**的死循环,最终耗费的总 Token 甚至能反超旗舰。
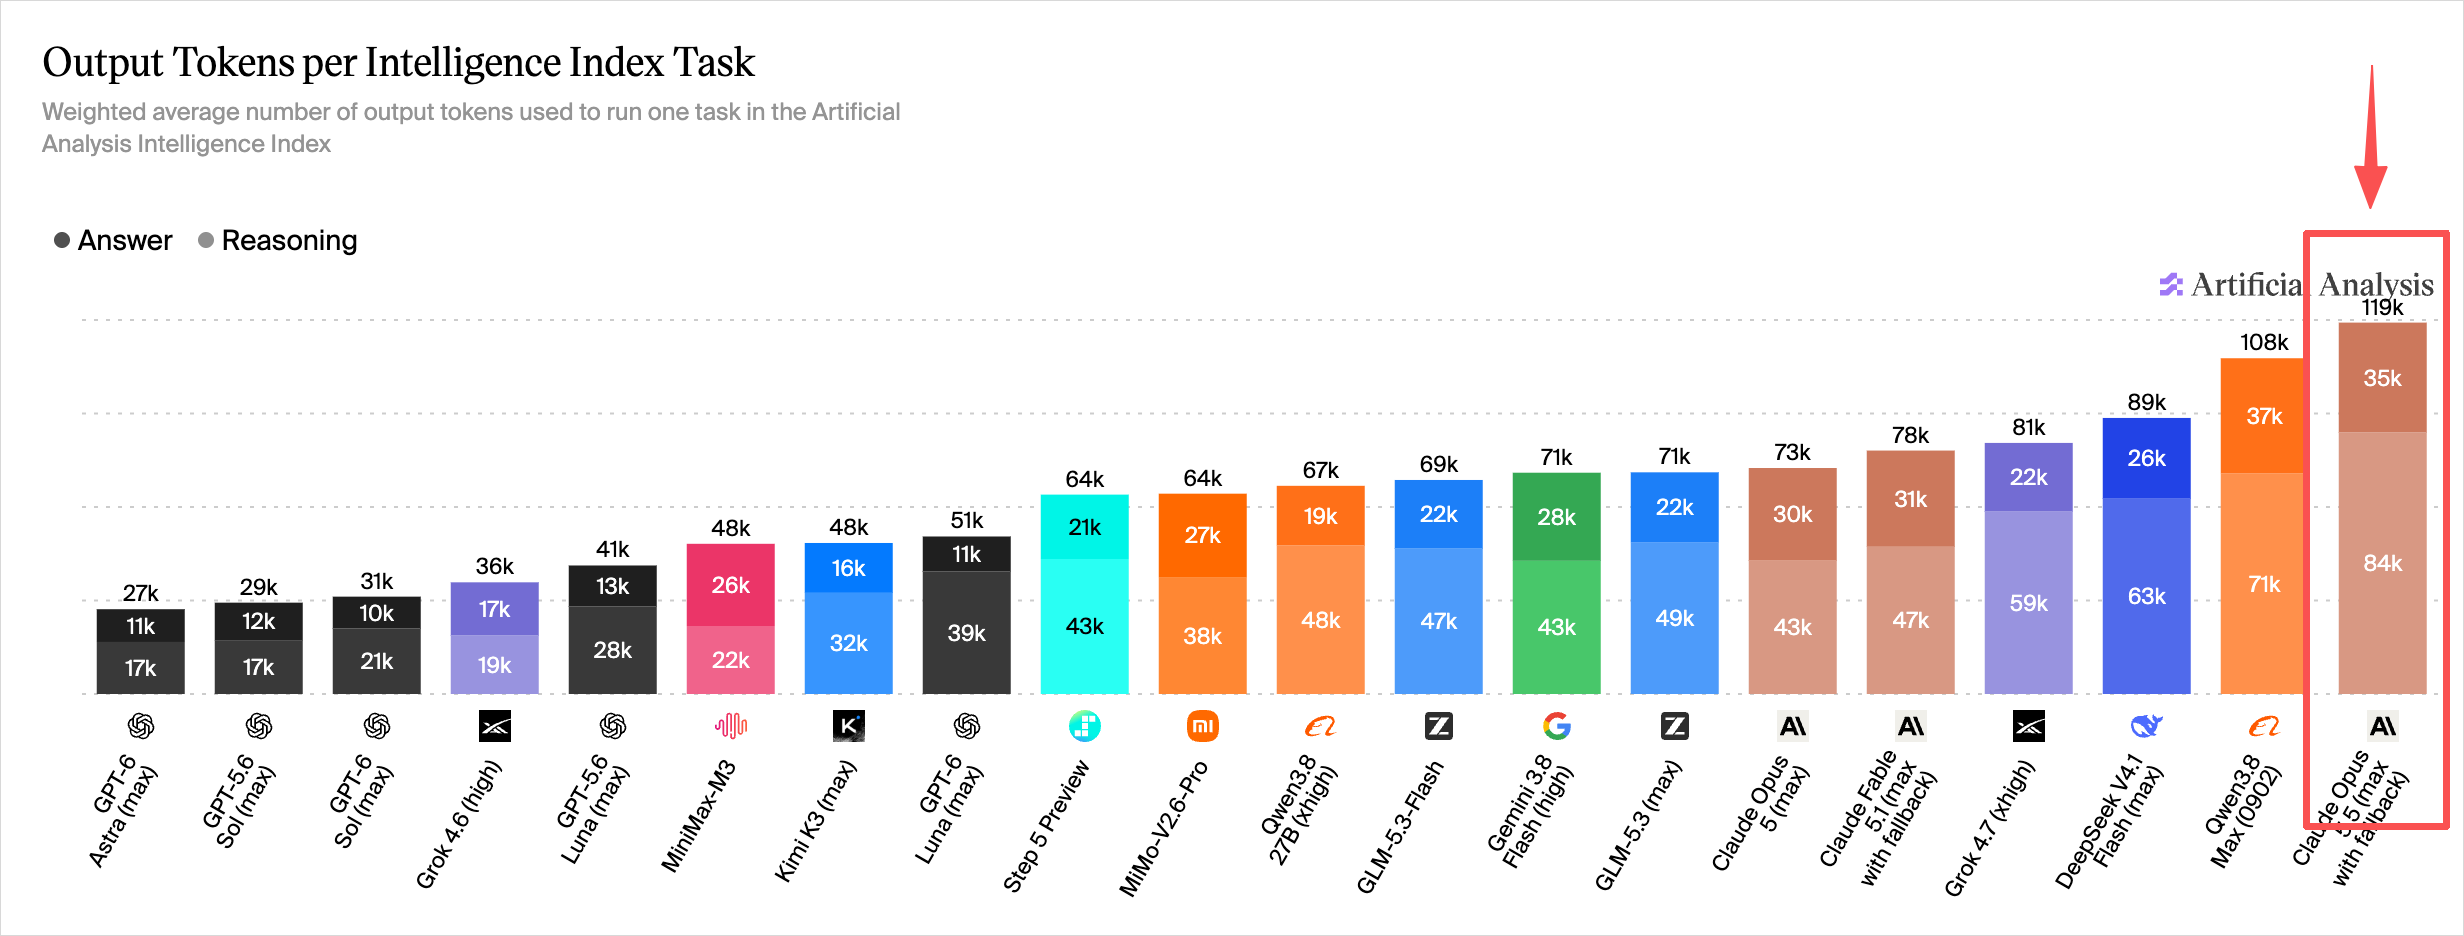 ▲ 任务输出 Token 效率对比:Opus 5.5 倾向于耗费海量推理 Token 换取高智商解答
Opus 5.5 的高智力很大程度是用海量长推理 Token 堆出来的。Anthropic 官方也很坦诚地在文档里写明了升级规则:
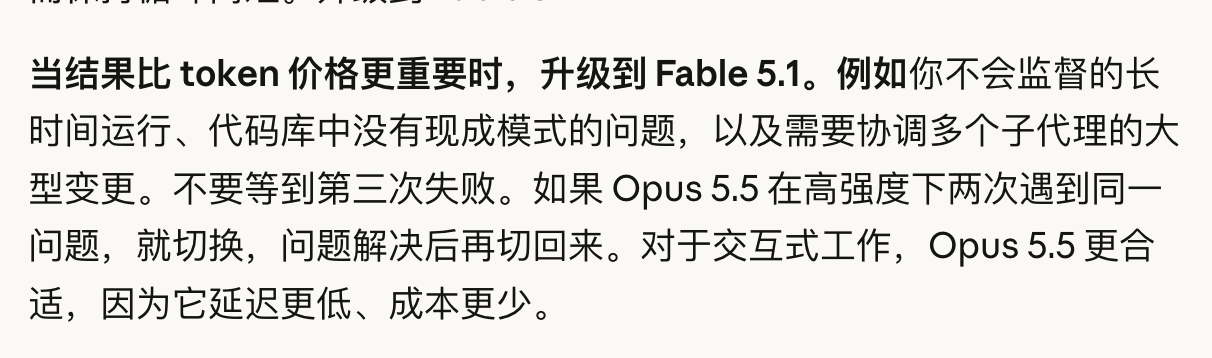 ▲ 官方文档明确指引:当任务结果的绝对准确性高于 Token 成本时,请直接上 Fable 5.1
审美与细节实测
在审美与构思完成度上,Opus 5.5 提升极大:
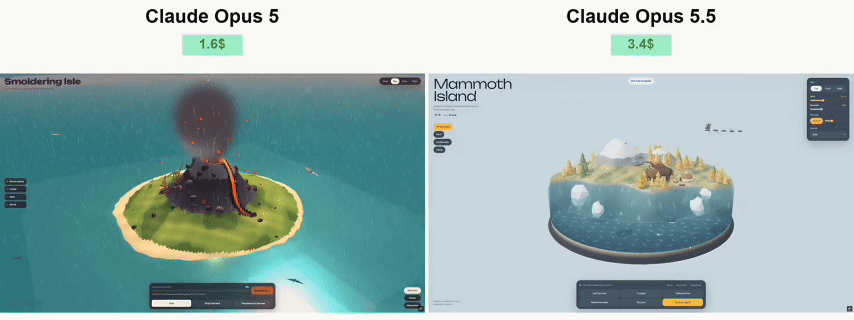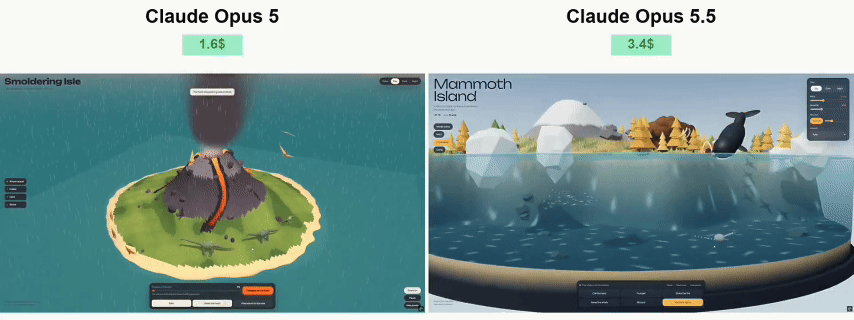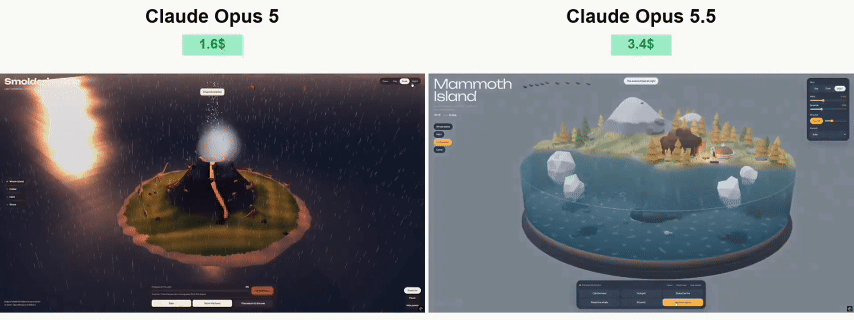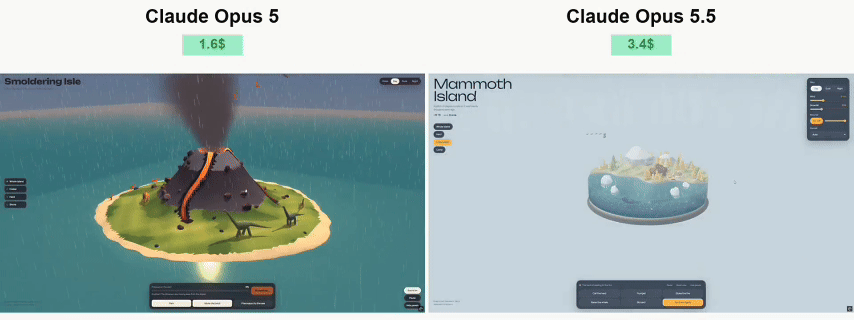 ▲ 生成细节实测对比:Opus 5.5 展现出极强的场景渲染与微观质感塑造力
社区推友 @notjazii 对比 GPT-6 Astra 与 Claude Opus 5.5,在很多前端与视觉呈现中,Opus 5.5 甚至比 Astra 更有设计感:
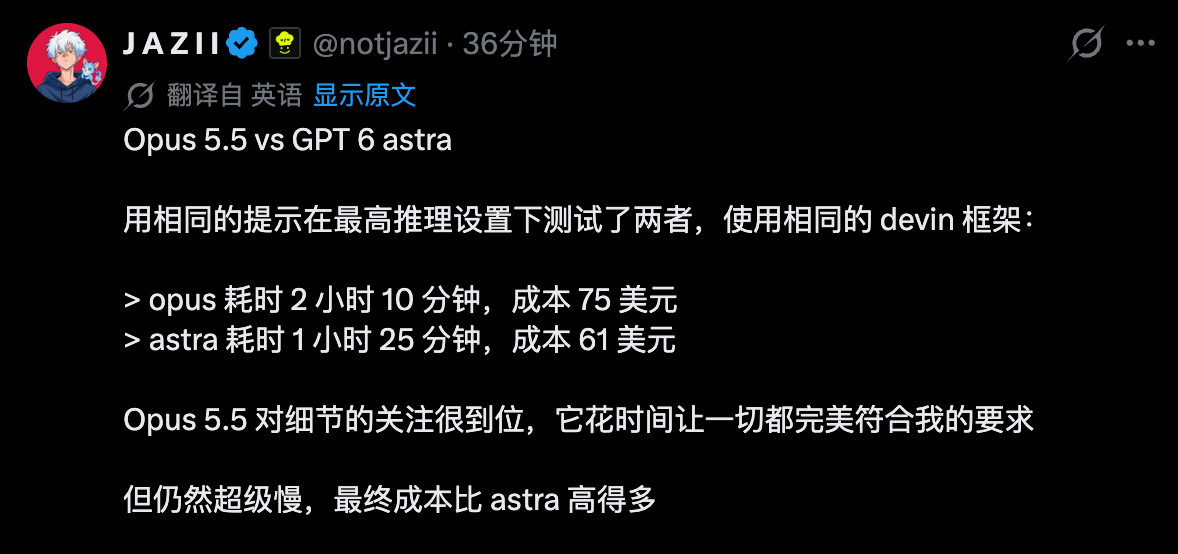 ▲ 社区实测:Opus 5.5 综合表现惊艳,但在部分长任务中耗时与费用高于 Astra
总结 Opus 5.5 的工作流定位:
- 日常盯盘的 Feature 开发、常规 Debug、Code Review:果断选用 Opus 5.5;
- 无人值守全自动化、架构底座设计、容错率为 0 的死命令:必须切回 Fable 5.1。
Fable 是军师,Opus 5.5 是冲锋陷阵的主力干将。
二、 GPT-6 Sol 与 Luna:极致效率与地板价的工业降维
终于轮到绝大多数人能日常高频使用的生产力工具了:GPT-6 Sol 与 GPT-6 Luna。
在 Codex 与 ChatGPT 菜单中,两款新模型已经正式落地就绪。
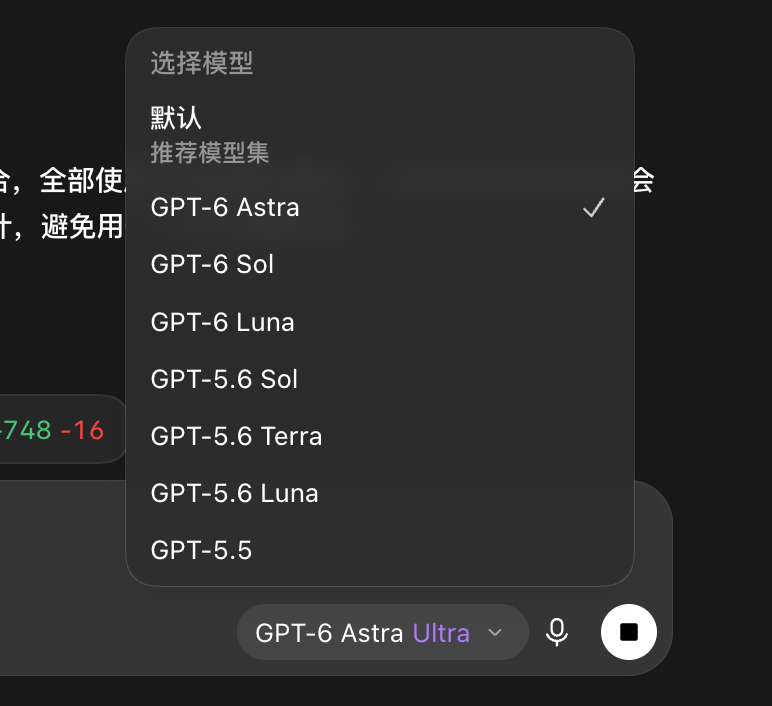 ▲ 客户端模型切换列表:GPT-6 Astra、Sol、Luna 矩阵全量开放
上一代 GPT-6 Astra 最大的痛点就两个字:贵、卡。普通订阅用户的额度分分钟见底。
OpenAI 这一次的打法极其明确:打穿成本,重构能效比(帕累托最优)。
- GPT-6 Astra:依旧是全家桶的战力天花板,专攻顶级疑难杂症;
- GPT-6 Sol / Luna:将 Astra 这一代的核心架构能力,下放给更敏捷、更便宜的规模化场景。
价格屠夫:比 GPT-5.6 腰斩 50%
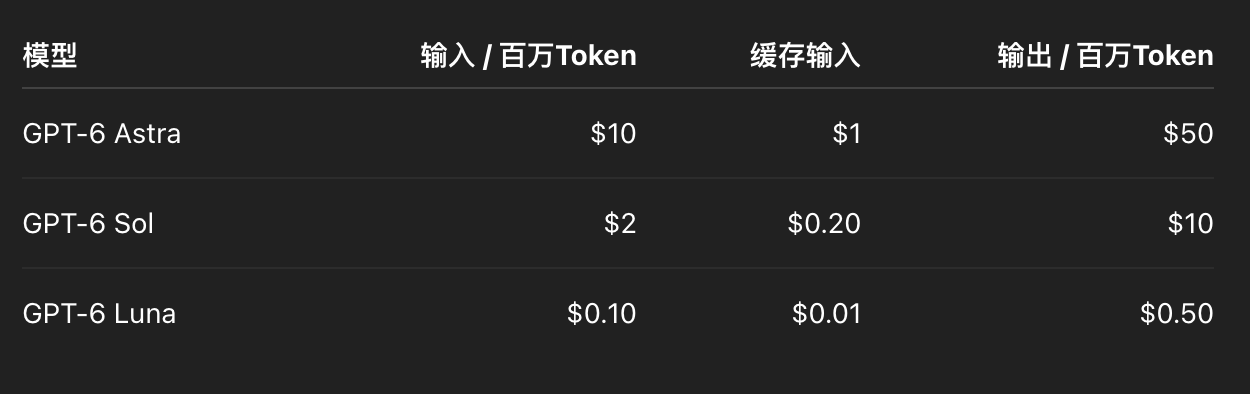 ▲ GPT-6 家族核心梯队定价结构明细
Sol 和 Luna 的定价,直接比上代 GPT-5.6 同级产品暴降 50%:
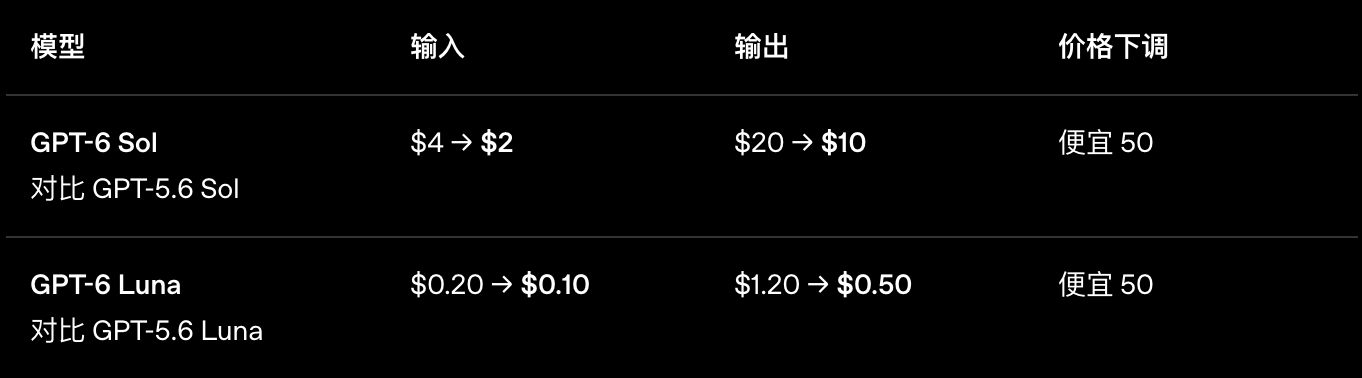 ▲ 降价幅度对比:中低阶模型迎来算力价格大腰斩
最离谱的是 Luna:
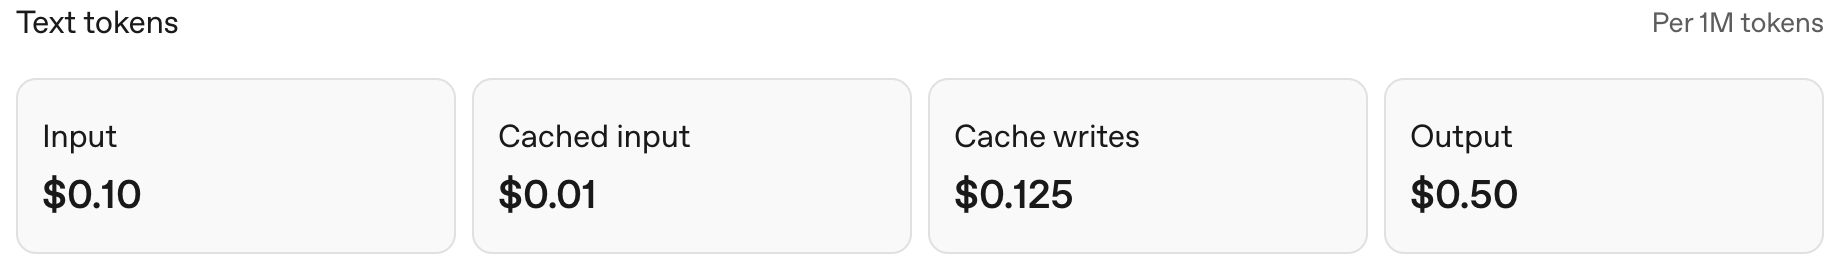 ▲ GPT-6 Luna 定价卡:输入仅 $0.10/M,输出仅 $0.50/M
单看纯输入与输出价格,Luna 甚至已经压到了比很多开源蒸馏版还低的水平。虽然高命中缓存价格仍需考量,但如果用于大批量低缓存命中的自动化工作流(如舆情监控、日均几万次的数据抽取洗涤),Luna 的性价比直接无敌。
规格与知识截止期对比
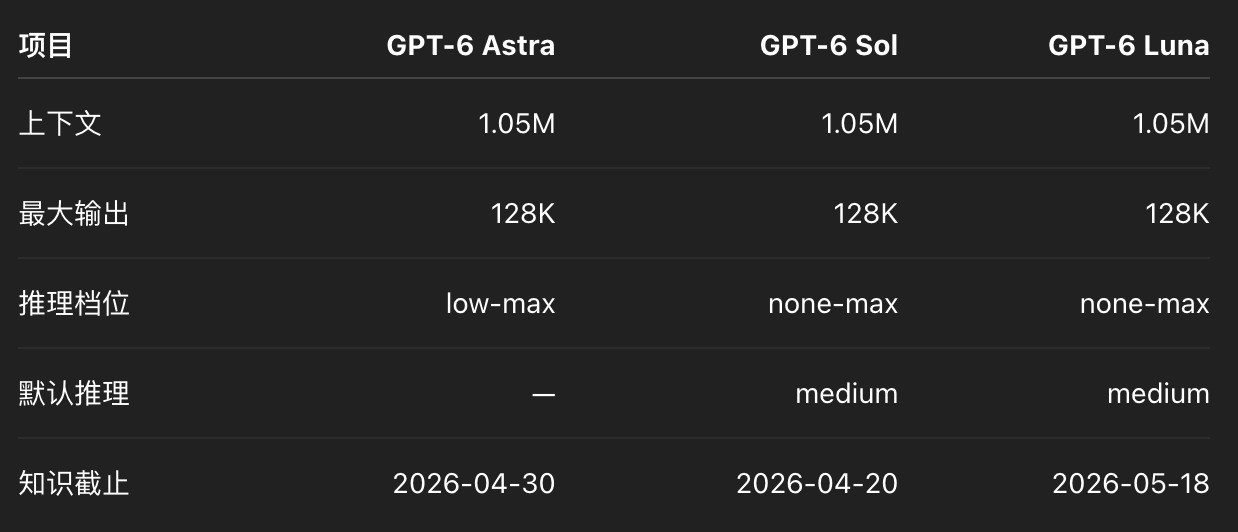 ▲ GPT-6 系列关键参数纵览(各版本知识库截止时间存在细微差异)
GPT-6 Sol 实测:重效率轻审美
在知名评测机构 Artificial Analysis(AA)的榜单上,GPT-6 Sol 的能力涨幅相对平稳,更偏向**"能力小幅微调、成本大幅腰斩"**;而 Opus 5.5 则是纯粹的"暴力刷分拿第一":
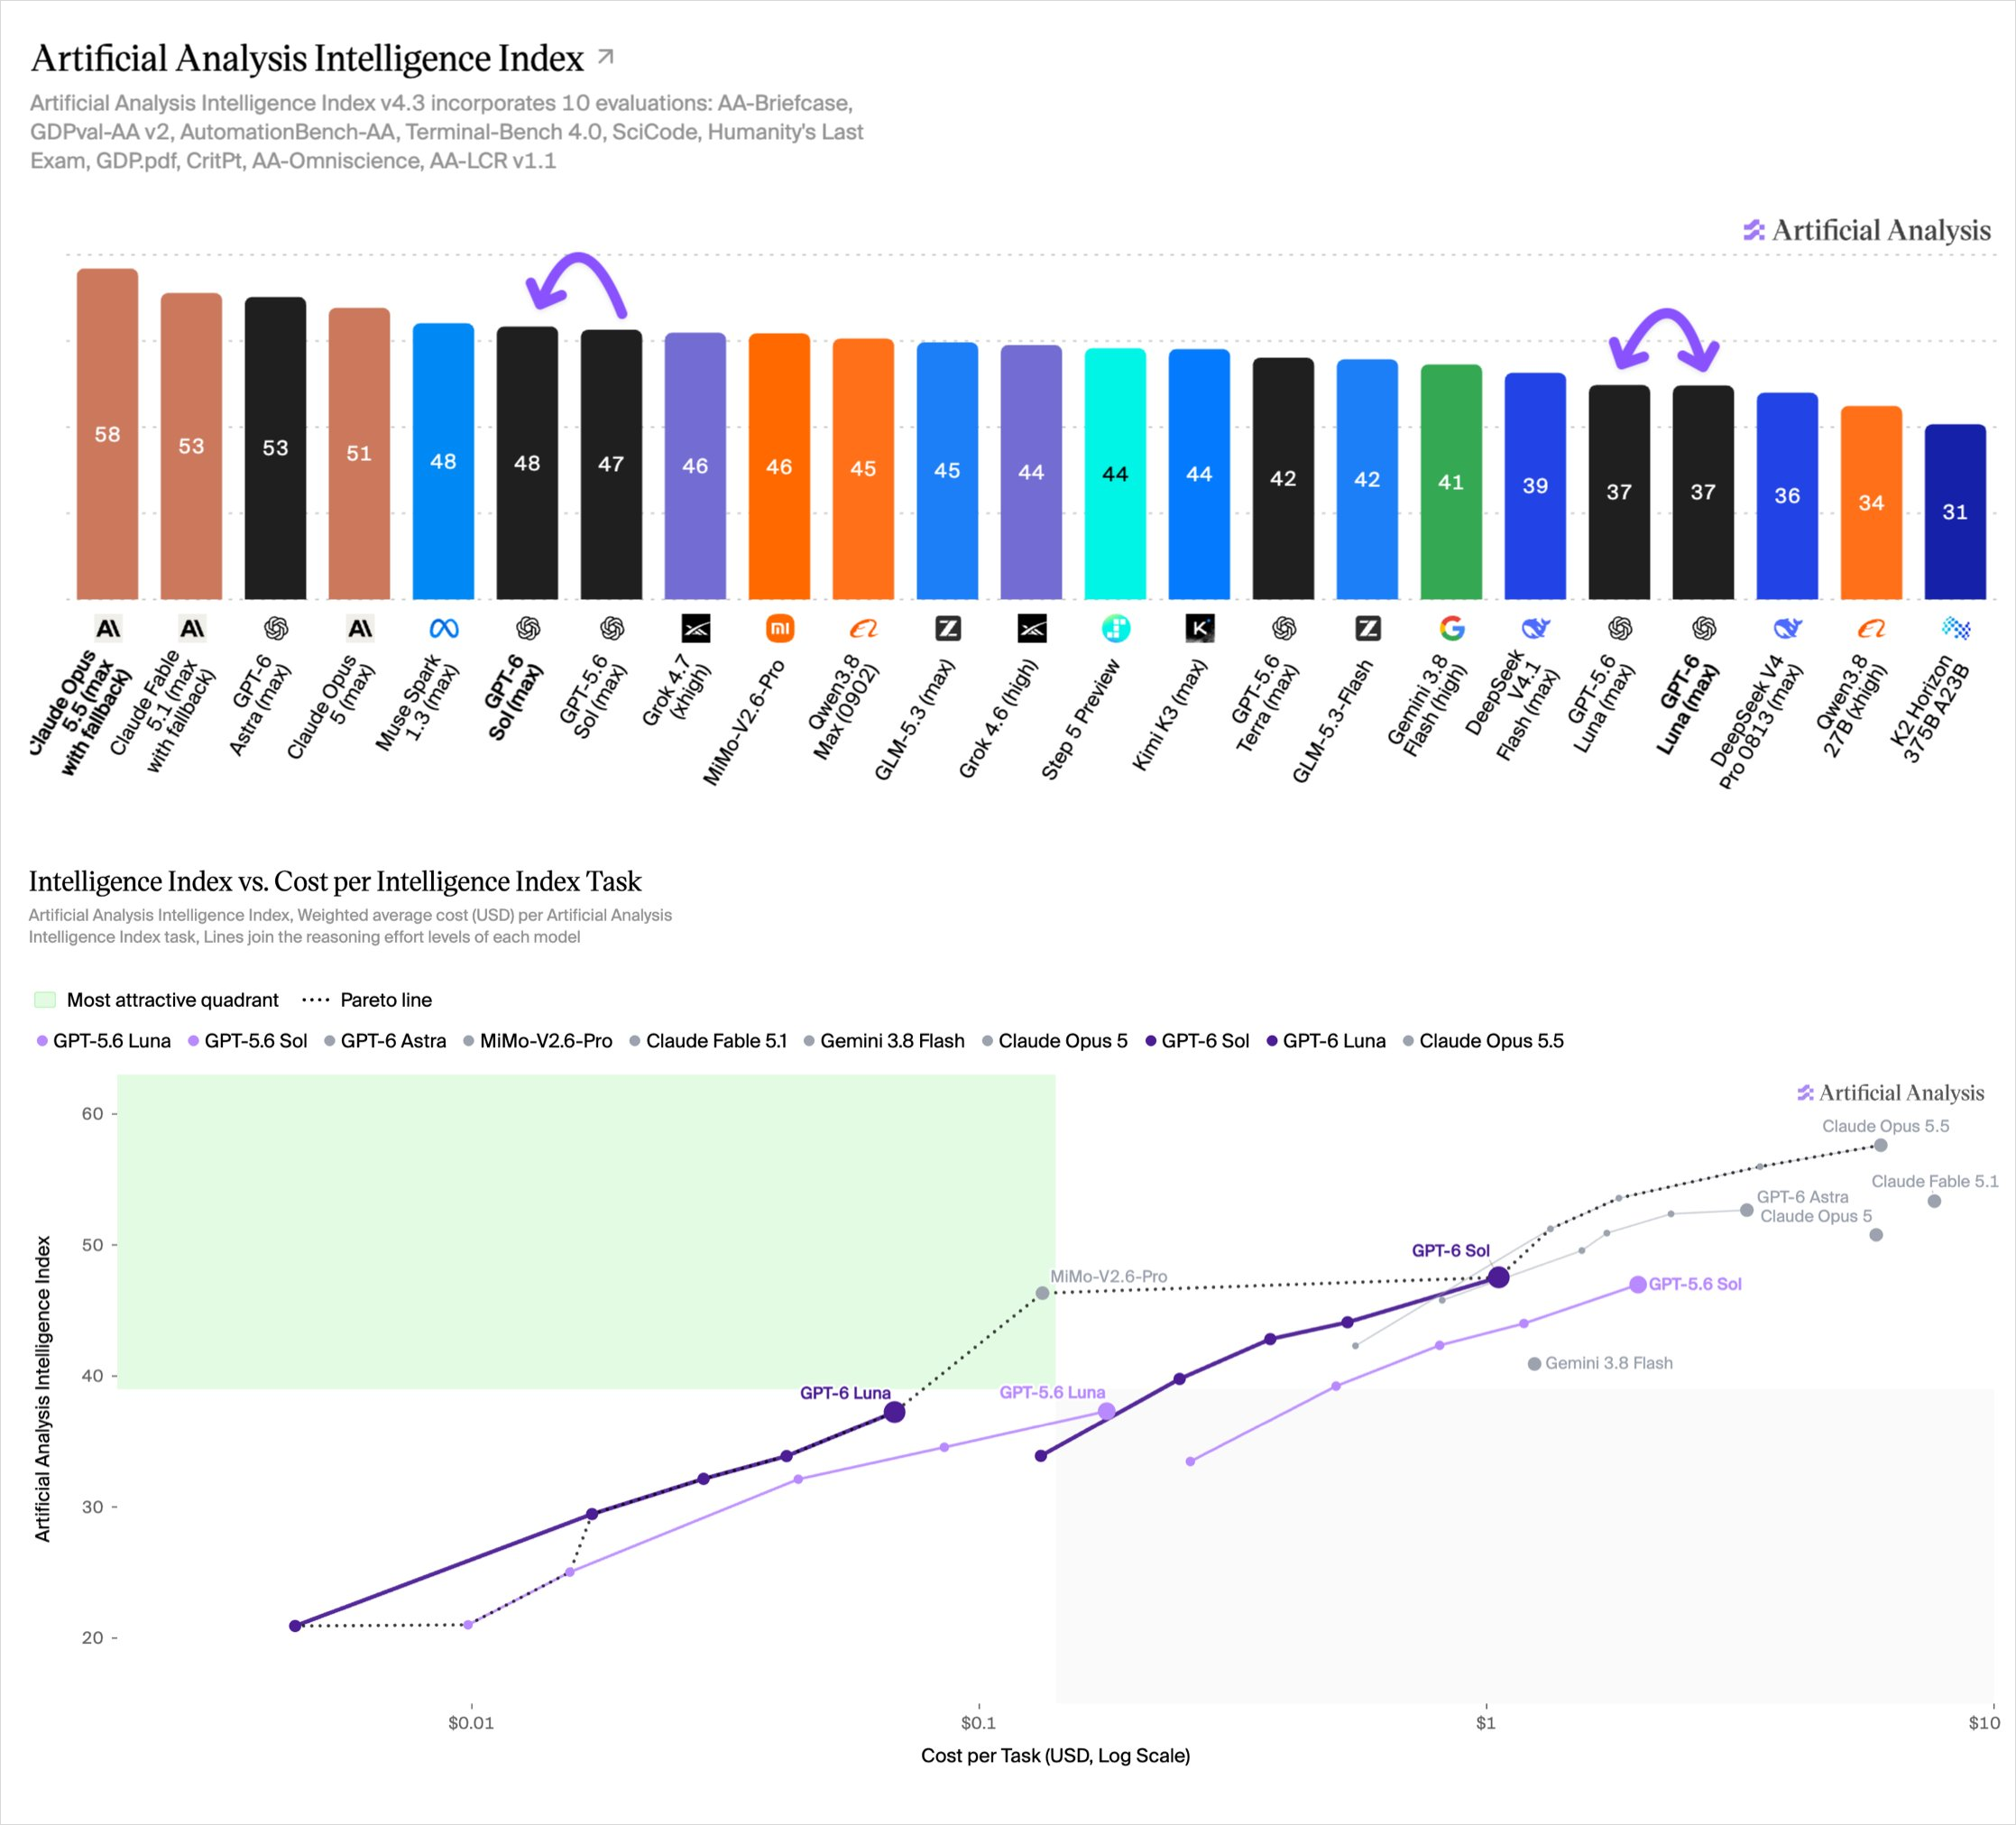 ▲ AA 最新智能指数与成本分布散点图
在衡量真实业务链条(销售、财税、运营等跨 47 种工具调用)的 AutomationBench 中:
- GPT-6 Sol (xhigh) 跑出了 33.2% 的优异成绩;
- 单任务成本仅需 $0.27;
- 相比之下,Astra low 成本是 Sol 的 3.9 倍,而 Fable 组合的成本更是达到了 Sol 的 8.9 倍以上!
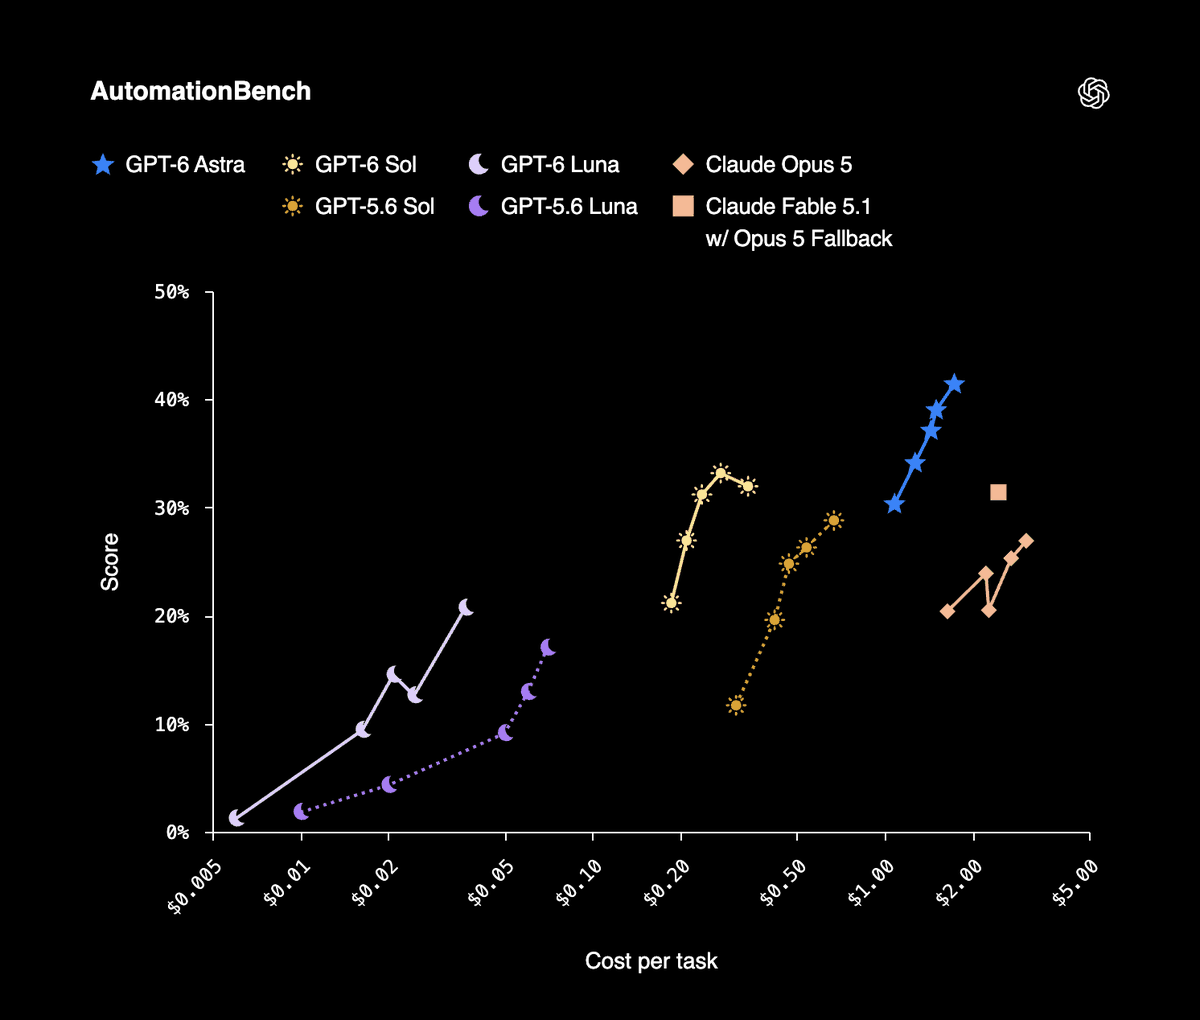 ▲ AutomationBench 任务得分与耗费成本曲线分布
更恐怖的是 Token 转换效率。GPT-6 系列惜字如金、直击要害,绝不在无效废话上烧你的钱:
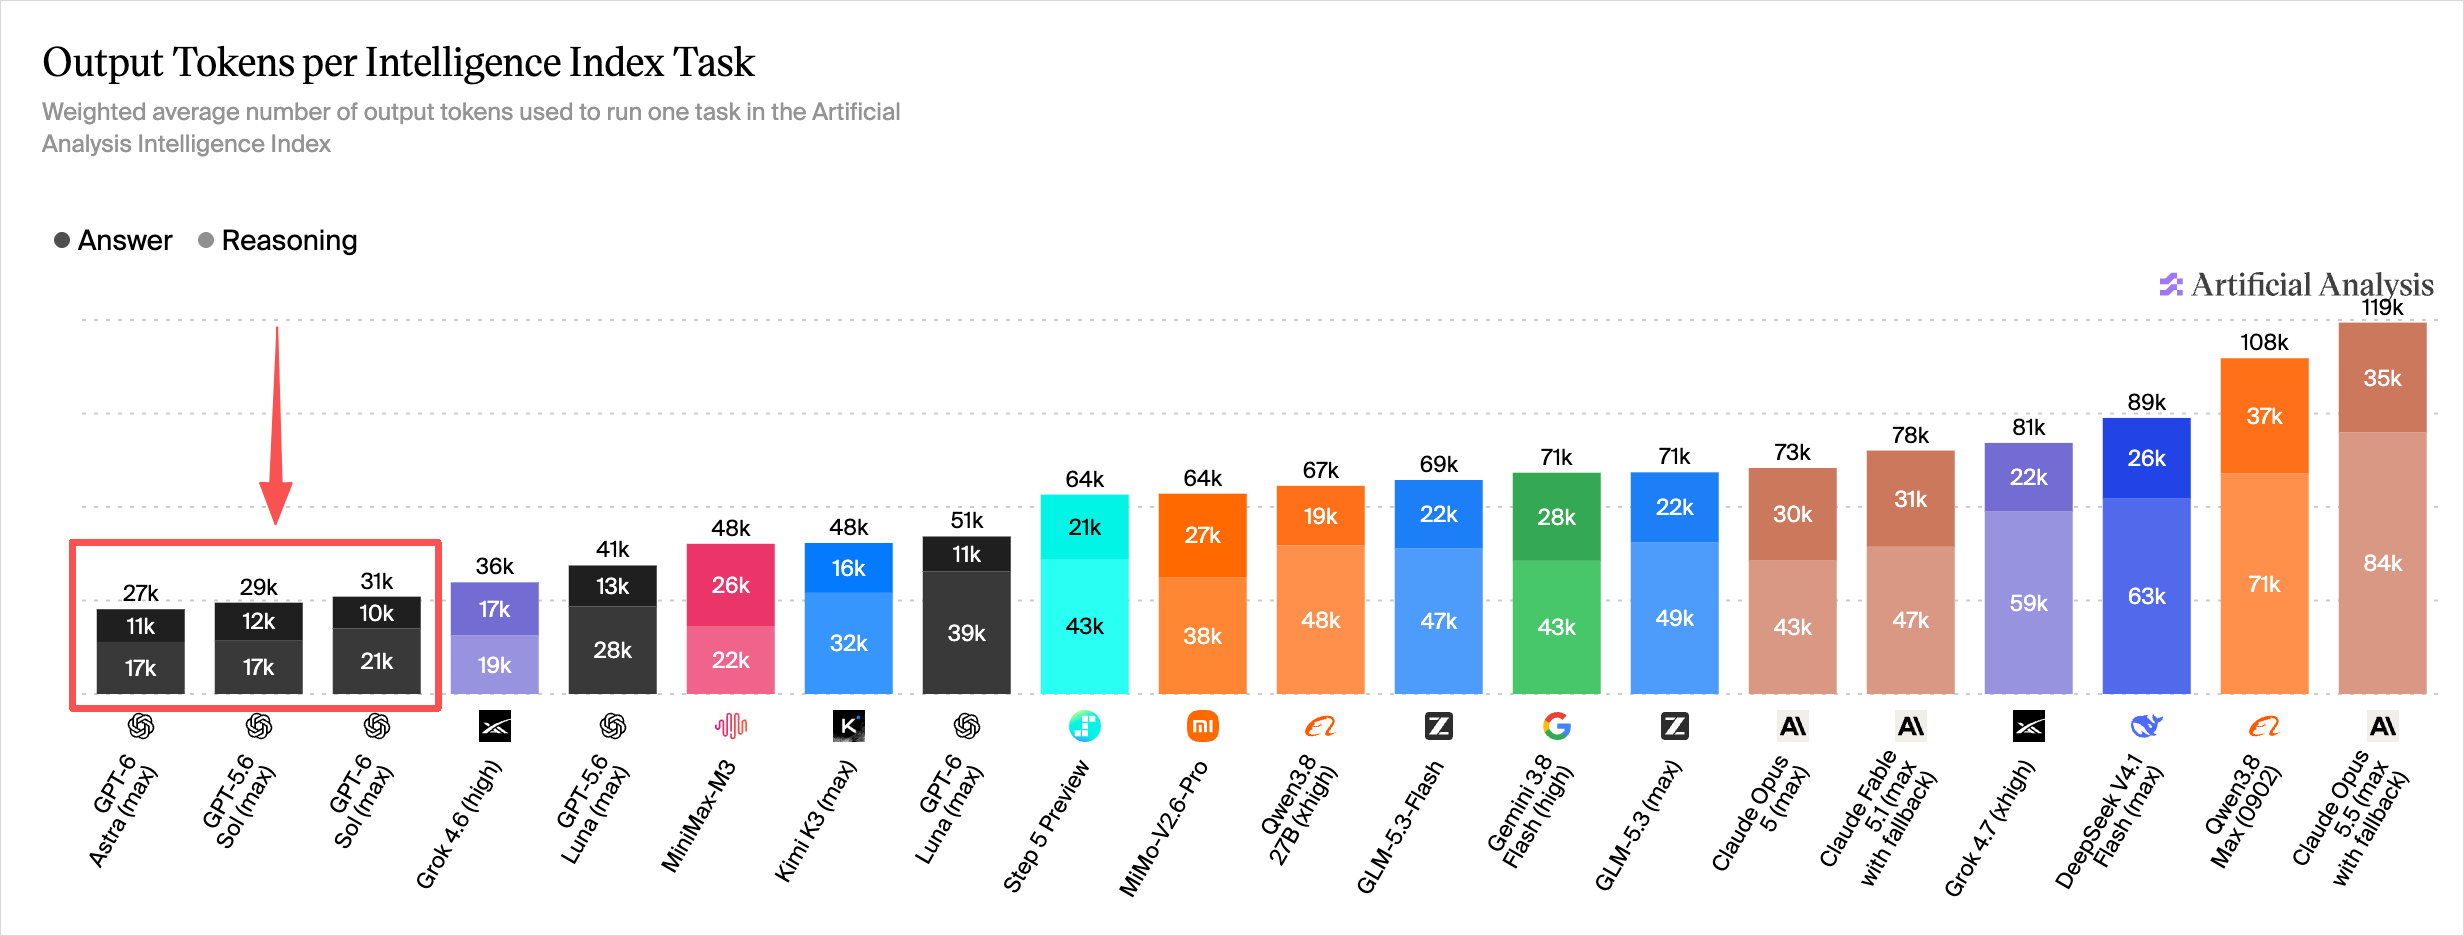 ▲ 输出 Token 消耗量:OpenAI 在信息压缩比与执行密度上显著优于竞品
幻觉控制与事实核查
GPT-6 全系最令人心安的升级是超低的事实错误率。它已经逐渐成为开发者的"全能事实核查机",幻觉率被压到了历史最低水平(建议在生产环境中将推理等级拉到 High 或 xHigh):
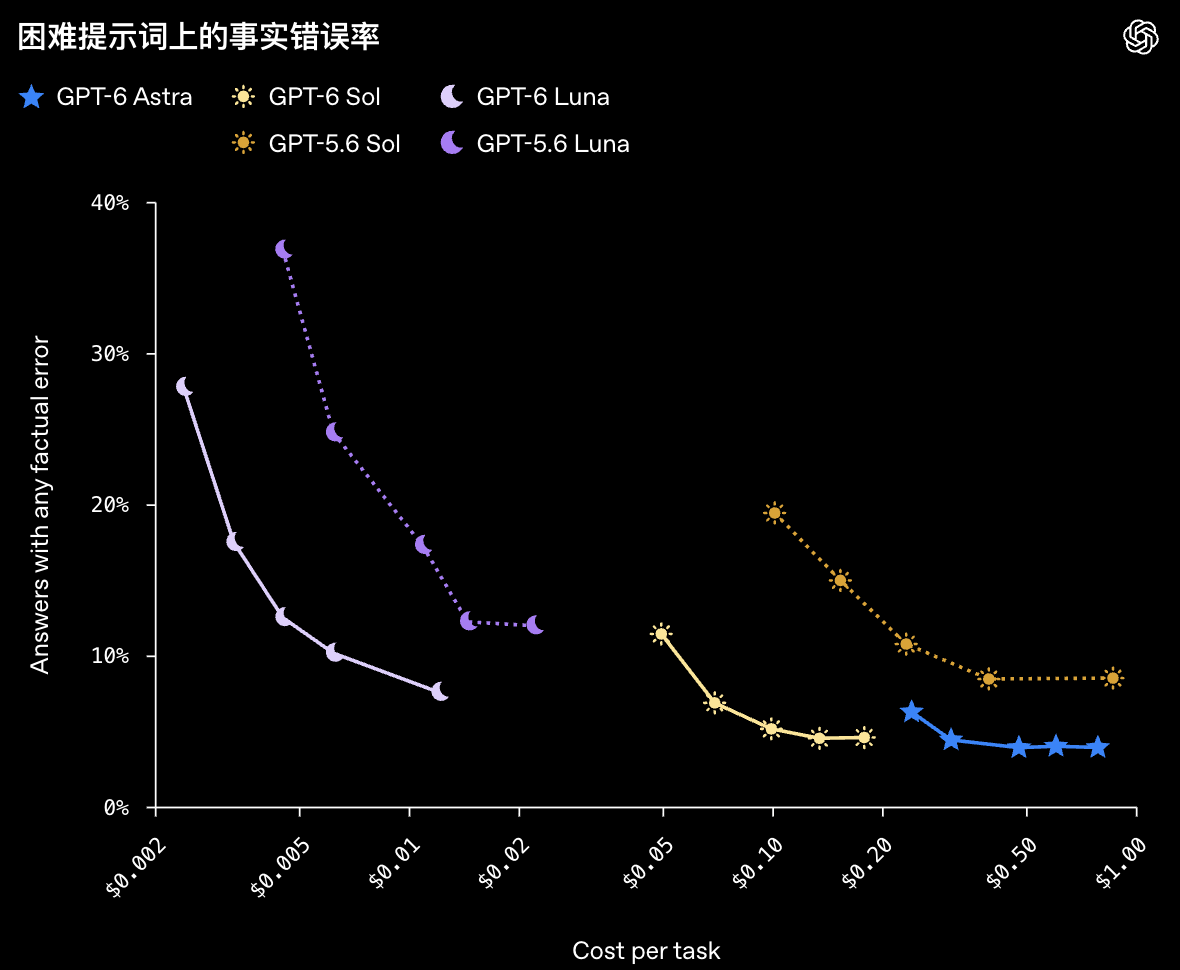 ▲ 困难 Prompt 下的事实错误率评测:高推理档位下幻觉被全面压制
刀法精准的代价:复杂空间审美降级
降价 70% 的代价,就是在长链审美与空间建模细节上被狠砍了一刀。
以 Blender 建模控制为例:
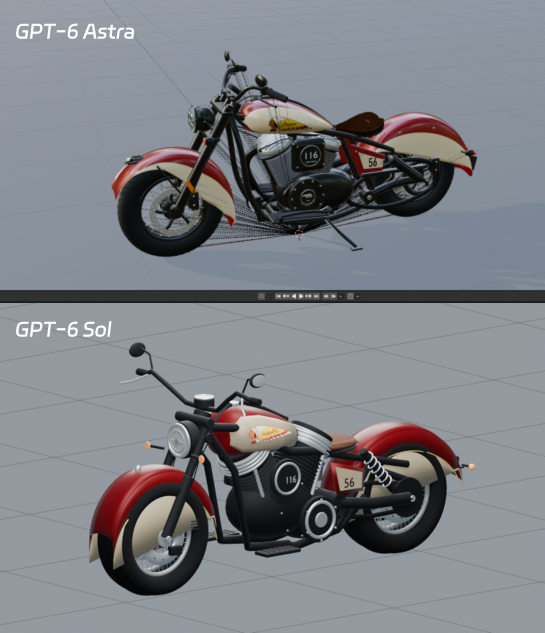 ▲ 3D 复古摩托车建模测试:Astra 细节结构严密,Sol 则出现明显的结构形变与缺失
再看经典的天坛祈年殿模型生成测试:
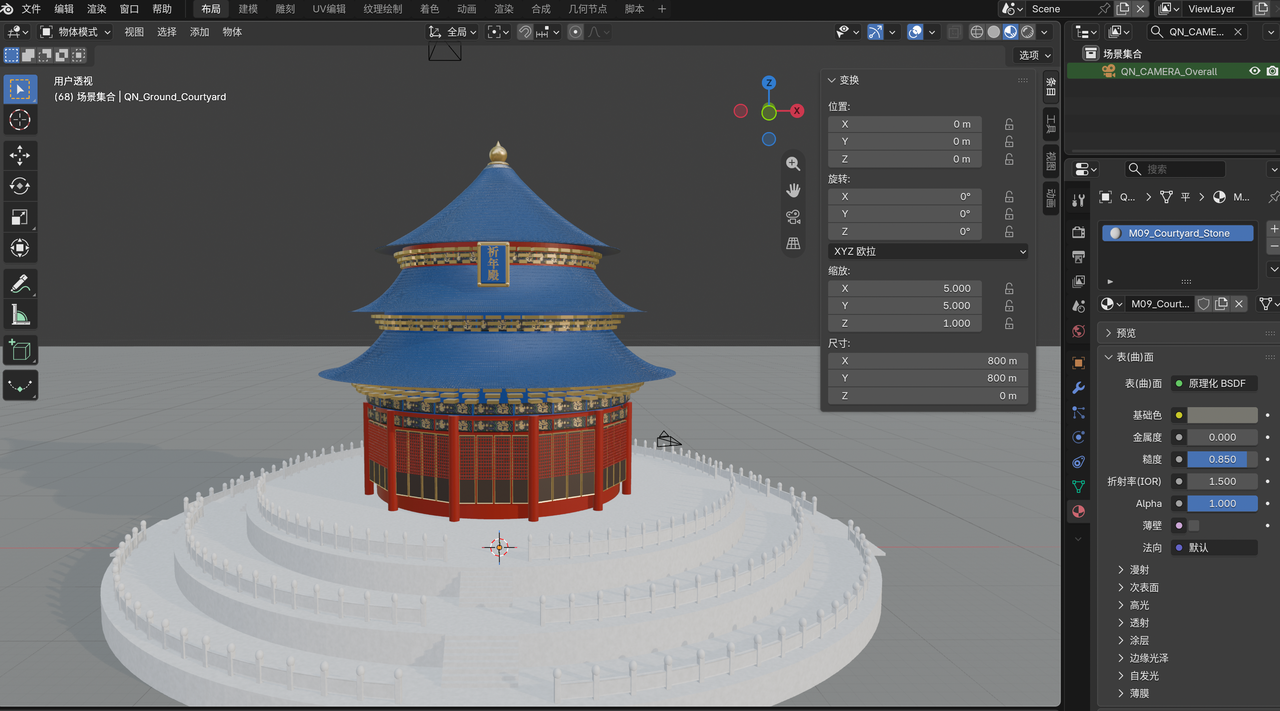 ▲ GPT-6 Astra 生成的天坛:斗拱、梁柱、台阶比例规整严谨
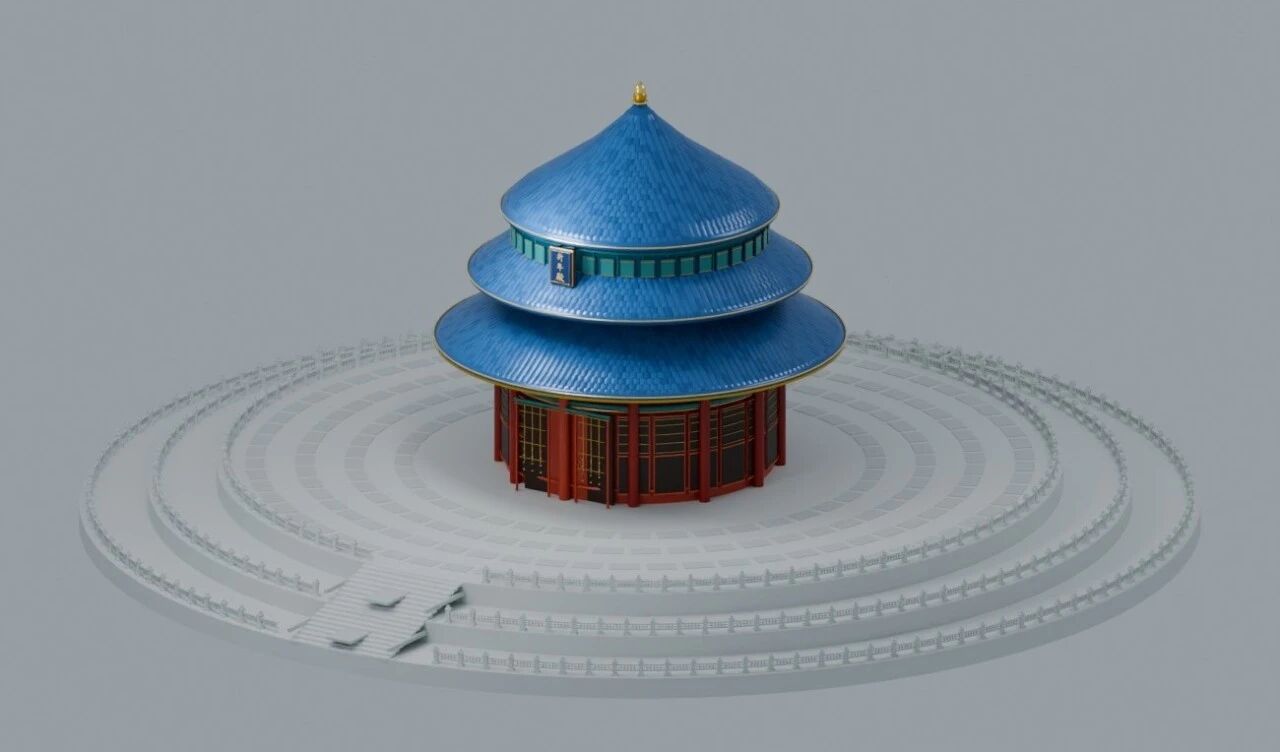 ▲ GPT-6 Sol 生成的天坛:门窗与排布明显存在错位与布尔运算 Bug
不过作为代价削减 70% 的工程副手,这种刀法完全在情理之中。
目前,Sol 与 Luna 已经在 Work 和 Codex 全面铺开:
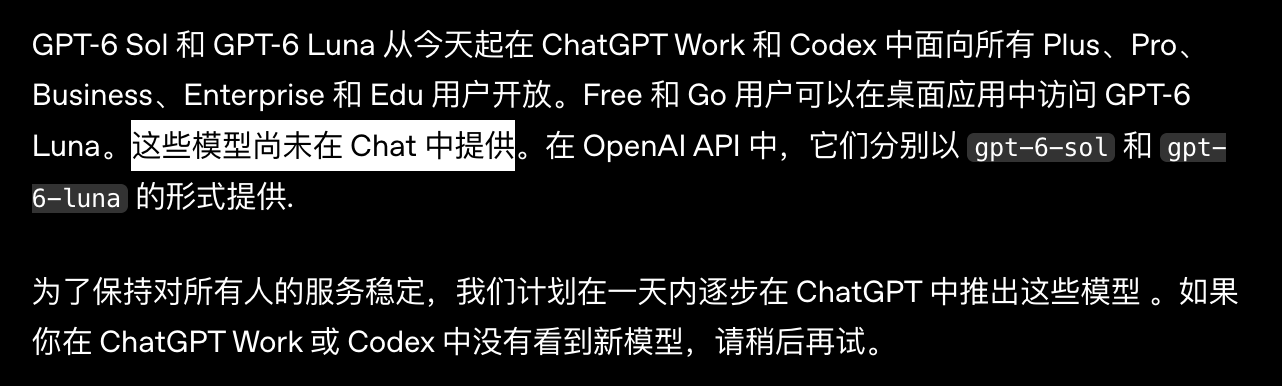 ▲ OpenAI 官方公告说明:新模型优先交付工作流与代码场景,普通纯聊天窗口仍保持灰度
选型指南:面对模型爆发,今天该怎么选?
模型多到眼花缭乱,大家最关心的落地选型建议直接总结如下:
1. Claude 订阅环境稳定(不被风控封号)
- 推荐方案:无脑首选 Claude 组合拳。
- 组合搭配:复杂全局规划、底层技术架构选择 Claude Fable 5.1;实际代码落盘、Bug 修正、特性开发常驻 Claude Opus 5.5。
2. Claude 易受限,但能稳定访问海外模型
- 推荐方案:拥抱 ChatGPT / Codex 工业生态。
- 组合搭配:GPT-6 系列综合 C 端体验更佳、生态最成熟。顶层架构使用 GPT-6 Astra(或 Pro);常规海量工程任务常驻 GPT-6 Sol (xHigh);批量数据洗涤与自动化后台全盘托付给 GPT-6 Luna。
3. 以国产大模型为主力工作流
- 推荐方案:Qwen、Kimi、GLM、MiMo、DeepSeek 当前均具备极高实用价值,梯队划分建议如下:
- 顶层推演与重度分析:Kimi K3 / Qwen 3.8 Max
- 高性价比日常代码落地:GLM-5.3 / MiMo v2.6 Pro / DeepSeek V4.1 Flash
- 订阅建议:只买月卡或季卡,切忌盲目囤年卡。整个行业的降价与迭代速度已经彻底脱缰。
以前是巨头垄断高端,国产拼性价比;现在 OpenAI 与 Anthropic 直接开启了**"高端、中端、低端全域通吃"**的工业化碾压模式。
但对所有开发者而言,每季度算力成本接近砍半,智能正在迅速演变为像自来水与电力一样的廉价公共基础设施。
属于每一个人的生产力大繁荣,真的来了。
附录:国内可用渠道与访问方式汇总
| 渠道类型 | 访问网址 | 适用场景 |
|---|---|---|
| GPT 国内高速镜像站 | https://trygpt.asia/list/#/home | 适合网页端免梯直接对话、工作流轻量体验 |
| MomoAI 包月套餐 | https://momoai.asia/home | 适合持续高频使用、希望按月订阅稳定套餐的用户 |
| 全模型 API 聚合站 | https://tryallapi.com/ | 适合开发者调用、低延迟直连、多模型一站式接入 |
| 官方代充通道 | https://chongzhi.trygpt.asia/ | 解决海外信用卡支付门槛,官方账户正规直充 |